Ajouter des pages ne répare jamais une page que Google refuse déjà de retenir. Un client qui réclame plus de pages sur son site WordPress vieillissant pousse souvent vers la mauvaise urgence : l’audit technique qui explique pourquoi les pages déjà en ligne restent invisibles passe avant l’écriture.
Le rapport « Indexation des pages » de Search Console distingue deux statuts pour une URL absente de l’index. « Détectée, actuellement non indexée » signifie que Google connaît l’adresse sans l’avoir explorée. « Explorée, actuellement non indexée » signifie que la page a été lue puis écartée. Le premier se corrige par l’accès et le maillage. Le second se corrige par le contenu.
Distinguer Détectée et Explorée, actuellement non indexée
Ouvrez Search Console, section Indexation > Pages. Pour une page « Détectée », Googlebot a repéré l’adresse sans l’avoir explorée. Pour une page « Explorée », il l’a lue et écartée, le plus souvent pour un motif de contenu ou de canonique.
Une page détectée réclame un lien interne solide et du budget de crawl. Une page explorée réclame un contenu propre, une balise canonique cohérente ou une fusion avec la page qui la remplace déjà. Confondre les deux coûte du temps sur le mauvais chantier.
Vérifier le noindex avant d’écrire une ligne
Ouvrez Réglages > Lecture. La case « Demander aux moteurs de recherche de ne pas indexer ce site » ne pose pas un simple noindex. D’après la documentation WordPress sur ce réglage, elle bascule l’option blog_public à 0 ; le cœur de WordPress ajoute alors la balise <meta name="robots" content="noindex,nofollow"> à chaque page, via l’API Robots ajoutée en WordPress 5.7, en 2021, qui a remplacé l’ancienne fonction wp_no_robots(). Contrôlez la valeur en une commande : wp option get blog_public en WP-CLI. Un retour à 0 signifie que le site entier échappe à l’index, liens compris.
Si le réglage global est correct, le noindex peut venir d’ailleurs. Yoast SEO, Rank Math et SEOPress posent chacun leur propre consigne page par page. Chez Yoast SEO, la case vit sous Yoast SEO > Avancé, dans le bloc latéral de l’éditeur, avec la question « Autoriser les moteurs de recherche à afficher cette page… » réglée sur Non. SEOPress range le même réglage sous SEOPress > Avancé. Une case cochée isolément peut désindexer une seule page de service sans toucher au reste du site.
Contrôlez enfin ce que le serveur envoie réellement. La commande curl -I https://votredomaine.fr/votre-page/ affiche les en-têtes HTTP renvoyés ; cherchez une ligne X-Robots-Tag: noindex. Cette consigne se pose côté serveur, sans passer par le HTML de la page. Aucune extension WordPress ne l’affiche dans son interface. Quelle que soit la source du noindex, Search Console classe la page exclue sous le statut « URL marquée noindex ».
Robots.txt : l’accès avant l’indexation
Robots.txt et noindex répondent à deux questions différentes. Le premier autorise ou bloque l’exploration d’une URL, le second se lit seulement après une exploration réussie. Google le précise : une page bloquée par robots.txt peut rester visible dans les résultats sous une URL nue, sans extrait, parce que Googlebot n’a jamais pu lire sa balise noindex. Vérifiez les deux consignes séparément.
Un robots.txt trop permissif ouvre un autre problème. Chaque bot autorisé à explorer consomme de la capacité serveur, parfois sur des URL sans intérêt réel comme la recherche interne ou la pagination profonde. Cette charge générée par les robots d’indexation réduit la marge disponible pour Googlebot sur les pages qui comptent réellement. Un changement dans le fichier met aussi du temps à être pris en compte : Google met en cache le robots.txt jusqu’à 24 heures avant de relire une version modifiée. Au-delà de 500 Ko, Google ignore le reste du fichier : un robots.txt qui accumule des règles sans les factoriser finit par perdre ses dernières lignes. Beaucoup de fichiers ajoutent aussi une ligne Sitemap: en fin de fichier, une convention qui remonte au protocole Sitemaps de 2005 et qui aide les moteurs autres que Google à trouver le plan du site sans passer par Search Console.
Le sitemap ne remplace ni un lien ni une page accessible
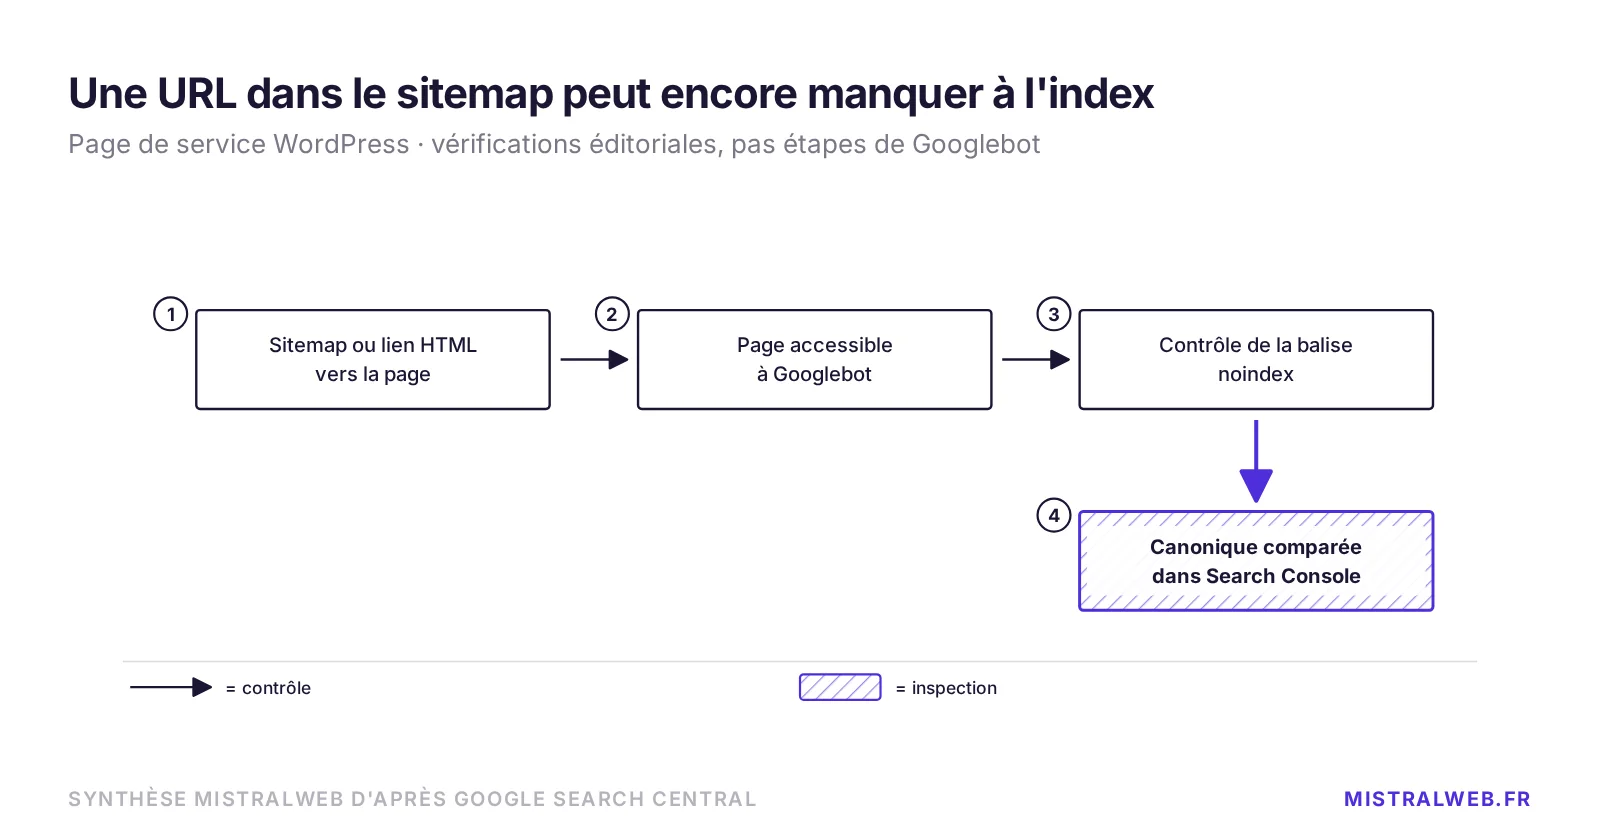
Un sitemap signale une URL à Google. Il ne garantit ni son exploration ni son indexation. WordPress génère le sien nativement depuis la version 5.5, publiée en 2020, via la fonction wp_sitemaps_get_server, à l’adresse /wp-sitemap.xml : chaque fichier liste au maximum 2000 URL avant que WordPress n’en crée un second, un plafond ajustable via le filtre wp_sitemaps_max_urls, jusqu’à 50 000 sous-fichiers référencés dans l’index principal. Une extension SEO peut remplacer ce sitemap par le sien et exclure certaines pages selon ses réglages de visibilité, sans toujours prévenir de ce choix. Un sitemap incomplet limite la découverte des pages ; il ne change rien à l’indexation de celles qu’il contient déjà. Comparez donc le fichier réellement servi avec la liste de vos pages prioritaires avant de le soumettre dans Search Console.
- Si une page attendue manque au sitemap, contrôlez sa publication et les réglages de visibilité de l’extension SEO avant de le resoumettre.
- Si elle y figure mais reste hors de l’index, inspectez son URL directement : la présence dans un sitemap aide la découverte, elle ne force pas l’indexation.
- Si Google ignore la page, cherchez un lien HTML depuis une page déjà accessible du site ; sans lien entrant, l’URL reste une page orpheline.
- Si Google connaît la page mais lui préfère une autre, comparez leur sujet et leurs signaux canoniques plutôt que de resoumettre le sitemap.
Google précise qu’un sitemap n’assure ni exploration ni indexation. Sa documentation sur les liens explorables recommande un attribut href lisible ; un bouton JavaScript sans adresse ne joue pas ce rôle, un piège fréquent sur un site construit avec un builder ou un thème à blocs.
Permaliens et canonique : choisir l’URL de référence
L’URL de référence se choisit sur la balise canonique et sur la structure de permalien retenue, dans cet ordre : la canonique tranche entre deux adresses proches, le permalien fixe ensuite l’URL qui doit rester stable. Avant de changer un permalien, ouvrez Réglages > Permaliens et notez la structure utilisée. D’après la documentation WordPress, un permalien est censé rester stable. Sur un site en production, une modification impose une redirection 301 pour chaque ancienne adresse, sinon les liens déjà diffusés atterrissent sur une erreur 404. Sur un hébergement Apache, cette redirection vit dans le fichier .htaccess à la racine du site ; sur Nginx, dans le bloc server de la configuration. Une extension de redirection évite de toucher directement à ces fichiers.
Comparez ensuite les URL qui affichent le même contenu sous des adresses différentes : version avec paramètre de campagne comme ?utm_source=newsletter, ancienne page issue d’un type de contenu personnalisé, doublon né d’un import ou variante mobile distincte. Vérifiez la balise rel="canonical" dans le code source et l’URL canonique déclarée par Search Console. Google distingue la redirection et la balise canonique, des signaux forts, de la simple présence dans un sitemap, un signal plus faible. Quand les deux versions restent trop proches pour que Google tranche comme prévu, Search Console signale la page sous le statut « Dupliquée, Google a choisi une URL canonique différente ». En cas de contradiction entre ces signaux, retenez l’adresse de référence et alignez les liens internes dessus.
Budget de crawl : le facteur qui pèse vraiment sur l’exploration
Le budget de crawl gouverne la fréquence d’exploration de Googlebot : la quantité de pages qu’il peut explorer sur une période donnée. C’est un facteur distinct des Core Web Vitals, qui mesurent seulement le confort de lecture d’un visiteur (LCP, INP, CLS) sans influencer la fréquence de passage du robot.
Google réserve ce guide en priorité aux sites de plus d’un million de pages mises à jour chaque semaine ou aux sites de plus de 10 000 pages mises à jour chaque jour. Un site vitrine de PME reste loin de ce volume. Le mécanisme opère pourtant à toute échelle : un serveur qui répond lentement ou renvoie des erreurs pousse Googlebot à réduire sa fréquence de passage, ce qui retarde l’exploration des pages « Détectée, actuellement non indexée ».
Un temps de réponse serveur élevé se corrige avant de toucher au JavaScript ou aux images. Le temps de génération d’une page WordPress dépend du cache full-page installé, du nombre de requêtes base de données par affichage et de l’hébergement lui-même. Un site sur un mutualisé saturé répond plus lentement à Googlebot qu’à un visiteur humain aux heures creuses, ce qui réduit le nombre de pages explorées chaque jour. Une page supprimée définitivement doit renvoyer un code 404 ou 410 : ce signal confirme à Google qu’il peut cesser d’y revenir, ce qui libère du budget pour les pages actives.
Demander une indexation et compter les délais réels
Demander une indexation prend un clic ; le délai réel se compte en heures ou en semaines, jamais en minutes. Une fois l’accès confirmé et le noindex écarté, vérifiez la balise canonique. Ouvrez ensuite l’outil d’inspection d’URL et cliquez sur « Demander une indexation ». Google a retiré son ancien outil Récupérer comme Google en 2019 au profit de cette inspection d’URL, qui couvre depuis à la fois le diagnostic et la demande d’indexation. Ce bouton place l’URL dans une file de crawl prioritaire, sans dépasser un quota quotidien fixé par Google ; il ne force ni un passage immédiat ni un résultat garanti.
Comptez large sur le délai. Une page techniquement propre peut être indexée en quelques heures comme rester plusieurs semaines dans la file, selon la fraîcheur perçue du site et la charge du moment. L’Indexing API se limite aux pages qui portent un balisage structuré « JobPosting » ou « BroadcastEvent », donc aux offres d’emploi et aux vidéos en direct. Une page de service ne rentre dans aucun des deux cas : le maillage interne et un sitemap à jour restent les seuls leviers réels sur sa vitesse d’exploration.
Le piège du contenu mince derrière un noindex bien réglé
Une page accessible, sans noindex, avec une balise canonique correcte, peut rester ignorée pour une seule raison : Google la juge trop proche d’une autre page du site ou trop pauvre pour mériter sa propre place dans l’index. Ce constat porte un nom : le thin content. Google a absorbé son système Helpful Content dans son algorithme de classement principal en mars 2024, avec un objectif annoncé de 40 % de contenu peu original en moins dans les résultats ; à la fin du déploiement, le 19 avril 2024, Google a rapporté 45 %. Le même type de signal qualité pèse sur la décision d’indexer ou non une page. Il explique une partie des statuts « Explorée, actuellement non indexée » que la case Réglages > Lecture ou robots.txt ne peuvent pas expliquer.
Une page de service qui reprend la structure et les phrases d’une autre page du même site, avec seulement le nom de la prestation changé, tombe dans ce cas. Ici, la correction touche le texte : des exemples différents, une réponse à une question que les autres pages ne couvrent pas déjà. La qualité éditoriale de la page fait la différence, bien plus que son balisage technique.
Questions fréquentes
« Détectée » ou « Explorée », laquelle inquiète le plus ?
La seconde. Une page détectée attend simplement son tour de crawl ; une page explorée a déjà été jugée par Google et écartée, ce qui demande de retravailler le texte plutôt que de patienter.
À partir de combien de pages non indexées faut-il s’inquiéter ?
La proportion sur les pages prioritaires compte davantage que le nombre absolu de pages non indexées. Quelques pages secondaires non indexées sur un site de 200 pages ne changent rien pour le client ; une seule page de service non indexée mérite un diagnostic immédiat.
Resoumettre le sitemap accélère-t-il l’indexation d’une page déjà connue de Google ?
Non. Le sitemap sert uniquement à la découverte d’une URL. Une page déjà « Détectée » ou « Explorée » ne gagne rien à une resoumission : son statut bouge seulement quand l’accès ou le noindex change. Le reste dépend de la canonique retenue ou d’un contenu retravaillé.
Quand relancer la production de pages
Une fois les corrections faites, repassez chaque URL de service concernée par la même série de contrôles, dans l’ordre :
- Accès public confirmé et statut noindex écarté sur la page inspectée.
- Balise canonique retenue par Search Console alignée sur l’URL de référence.
- Titre et meta description propres à la page, sans doublon avec une autre URL du site.
Google recommande des titres descriptifs et distincts, sans garantir qu’il reprenne le texte fourni tel quel dans les résultats. Sa documentation sur les extraits précise qu’il compose aussi la meta description à partir du contenu de la page.
Avant d’ajouter une nouvelle page pour un client, vérifiez qu’aucune page existante ne répond déjà à la même question sous une autre forme. Le chantier suivant porte sur la structure du maillage entre les pages, une question de plan de site qui dépasse l’indexation d’une URL isolée.